

不止于语言:多模态AI基础架构如何助力OEM打造更具上下文感知能力的车载体验
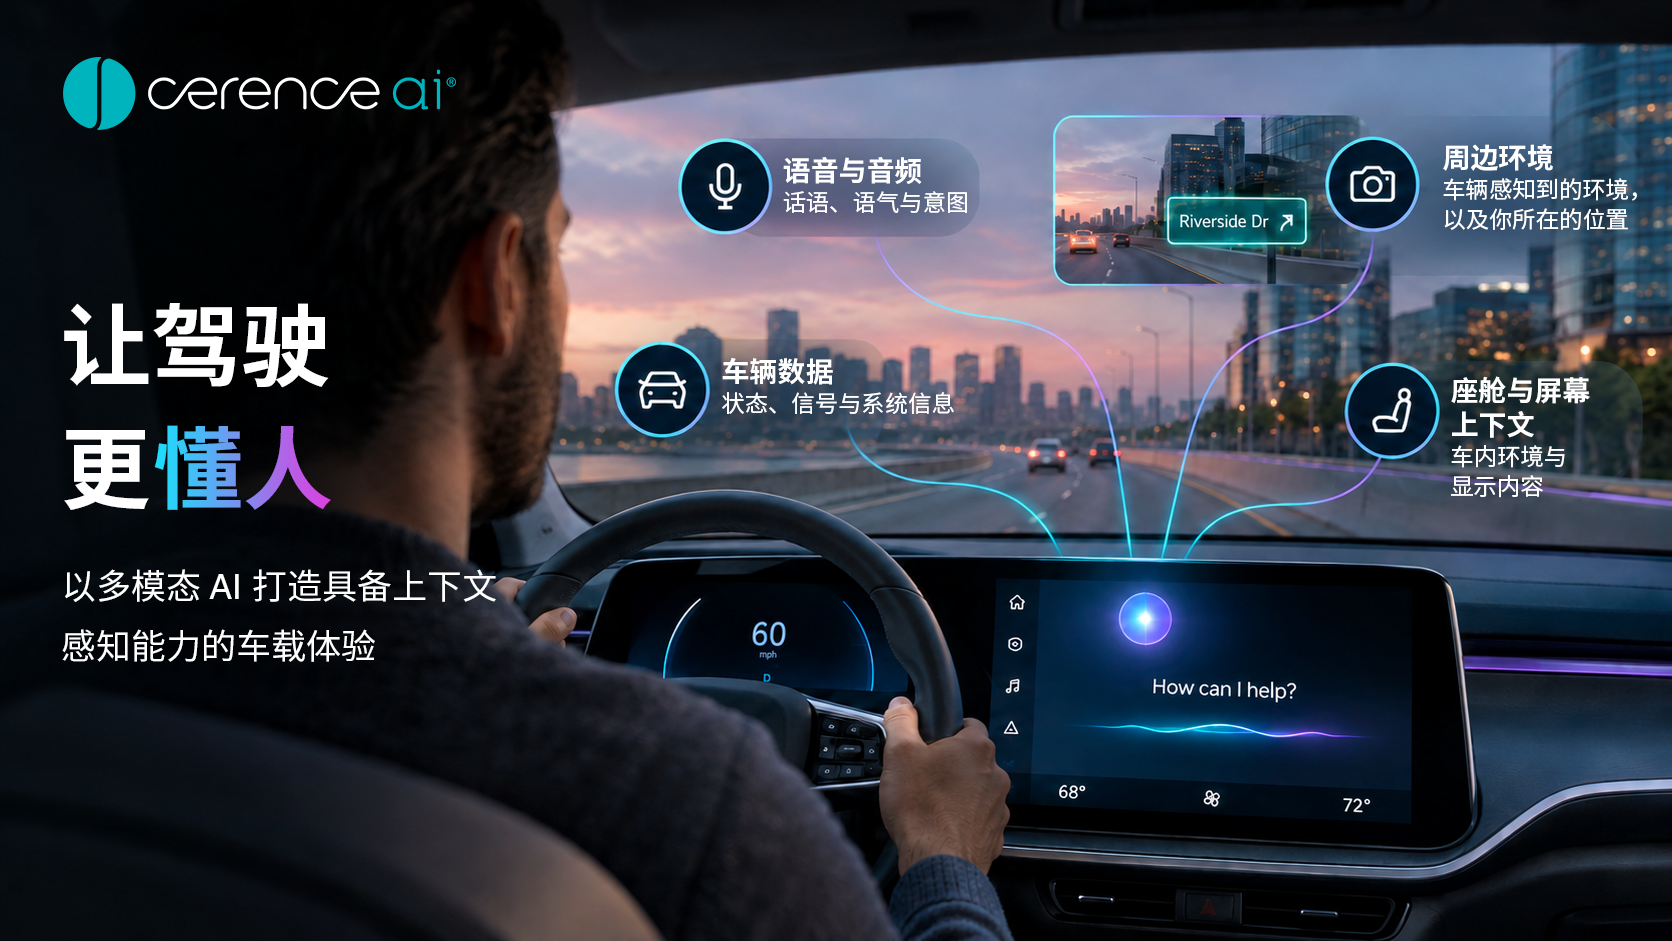
OEM正面临越来越高的期待:车载助手需要结合语音、视觉信号、车辆数据与周边环境,理解驾驶者的意图。如今,驾驶者期待的变化速度已经超过车辆本身的演进速度;要满足这些期待,就需要采用专为多模态推理而设计的架构。
对于OEM而言,这一选择的影响远不止某项单一功能或某一代模型。多模态基础架构能够带来更直观的交互体验,简化全球市场的部署,并在AI技术不断演进的过程中,更轻松地纳入新的能力。
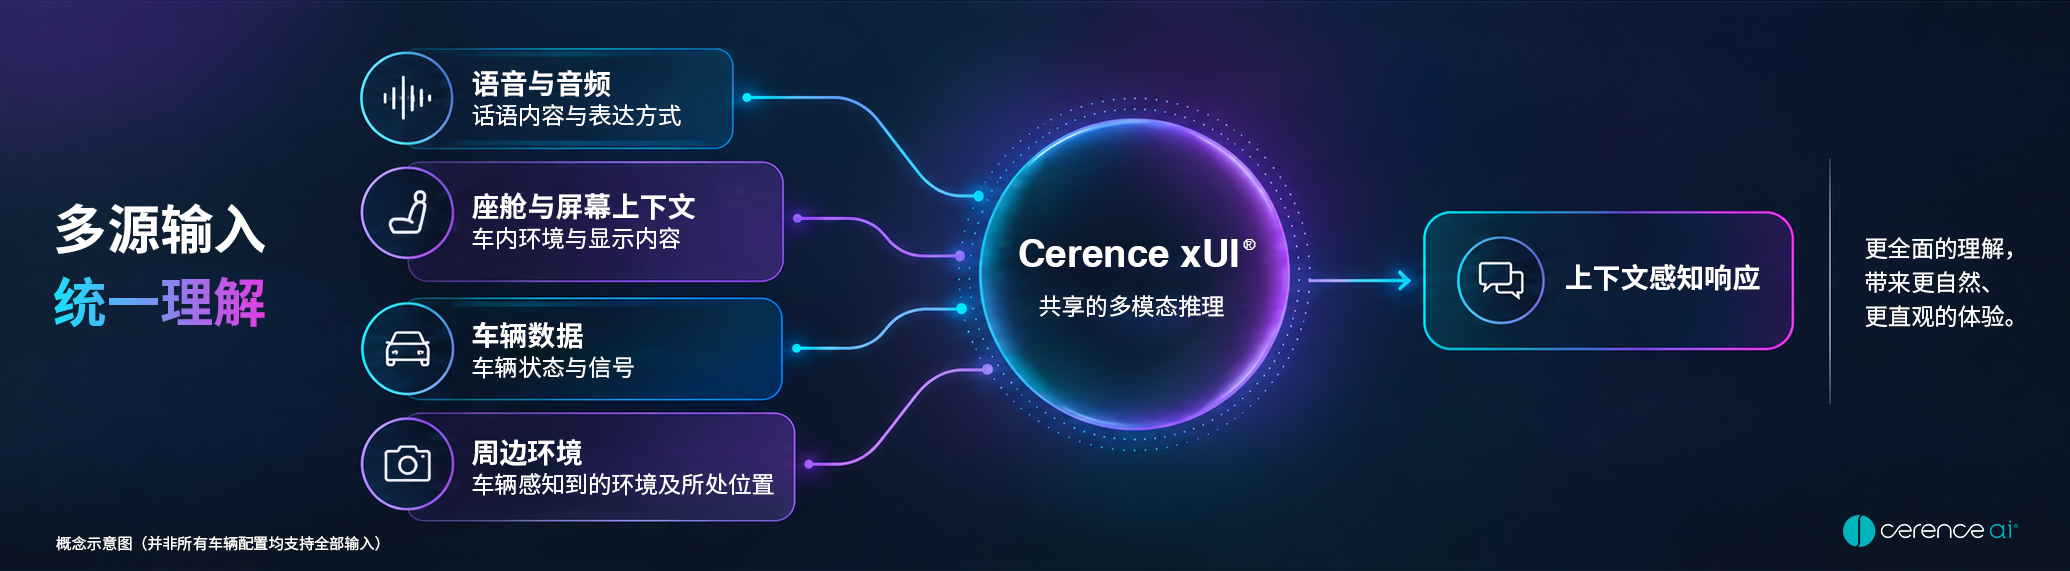
Cerence xUI®是我们的混合式车载AI平台,旨在将这些信息整合到同一个推理流程中,而不是分别处理。借助这一平台,OEM既能在当下带来更出色的用户体验,也能获得一套可在车辆全生命周期内持续演进的架构。
多模态能力始于架构
在xUI中,音频与视觉并不是后期才接入的功能。它们会进入同一个推理流程,用于判断驾驶者的需求。
随着模型能力不断提升,新能力可以持续融入车载体验,而底层平台依然保持车规级标准。
超越语音转录的推理能力
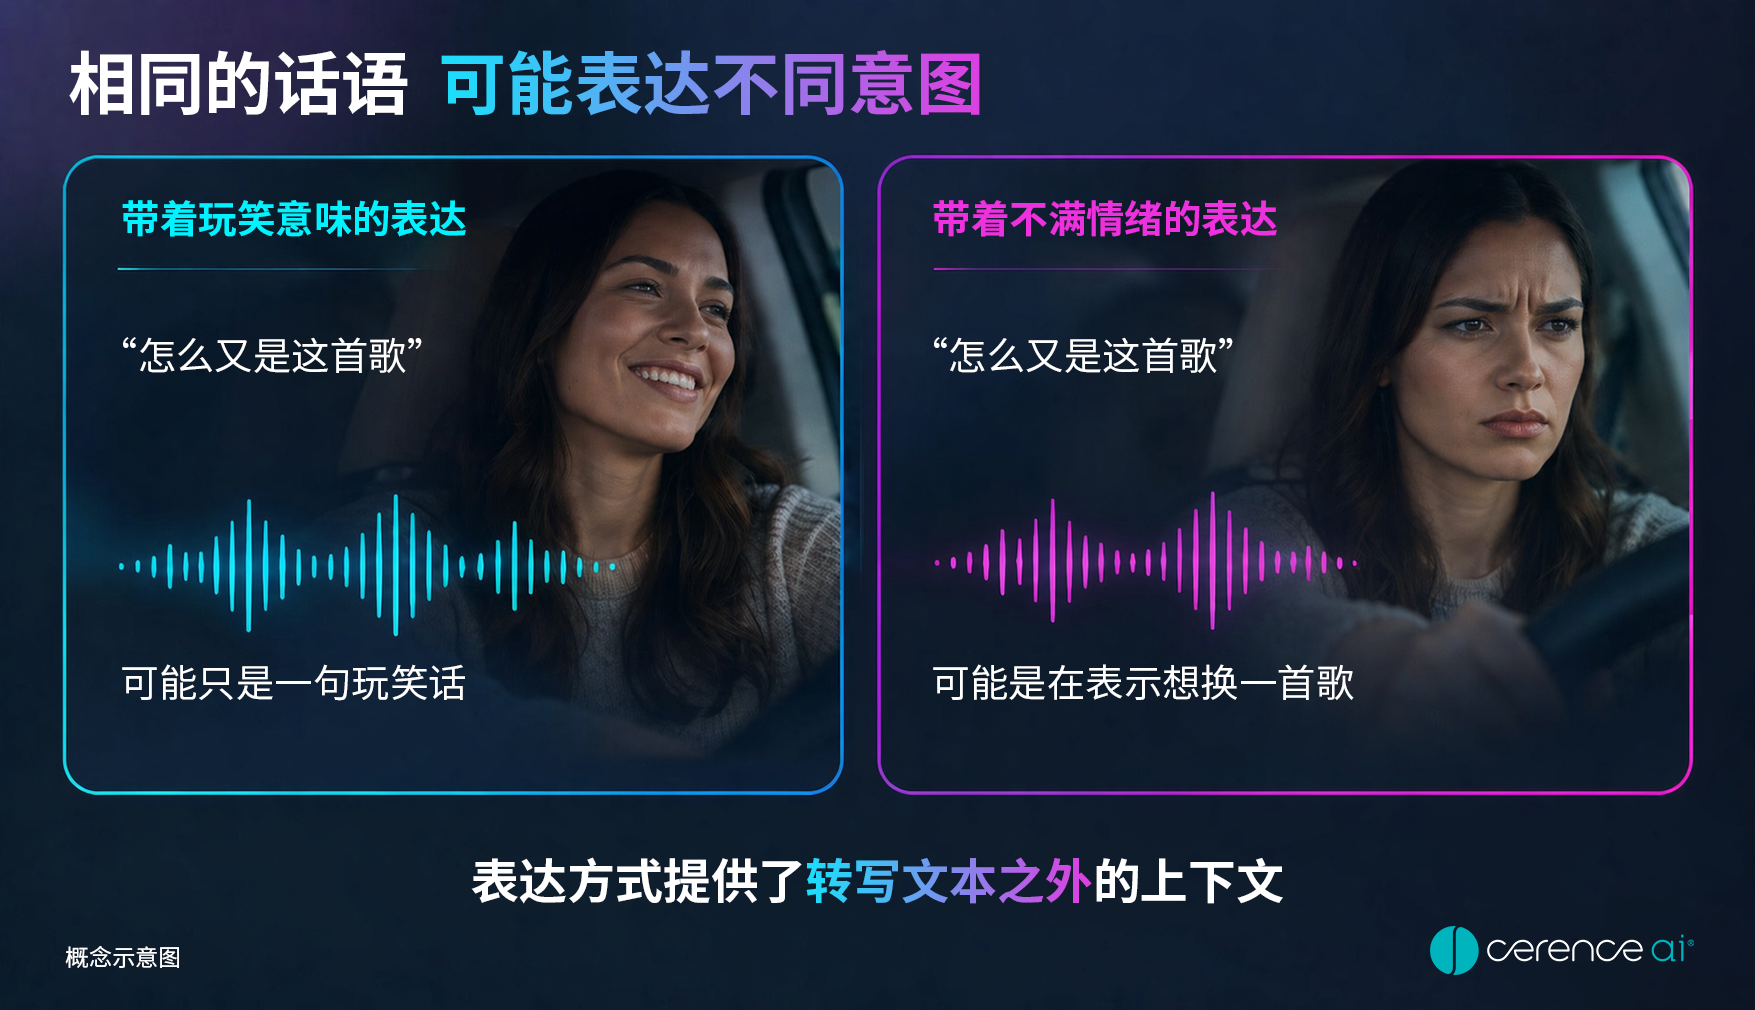
语音转录只能记录说了什么,无法呈现怎么说。
xUI支持模型基于完整音频信号推理,识别语气、急迫程度、迟疑停顿、口音、方言以及语言切换等信息。
比如,驾驶者说:“怎么又是这首歌。”无论这句话是带着打趣、烦躁还是讽刺的语气说出,转录文本都是一样的,但意图并不相同。助手能够听出其中差别,直接跳过当前曲目,而不是等待驾驶者明确说出“下一首”。
这也可以减少对各语言市场独立转录流程的依赖。随着音频原生模型不断优化,更多市场可以共享同一套架构。
对于OEM而言,这意味着他们可以持续引入语音与音频推理的新进展,而无需在每次模型迭代时重构整套车内体验。
让座舱成为对话的一部分
人们在车内说的很多话,都与眼前所见有关。
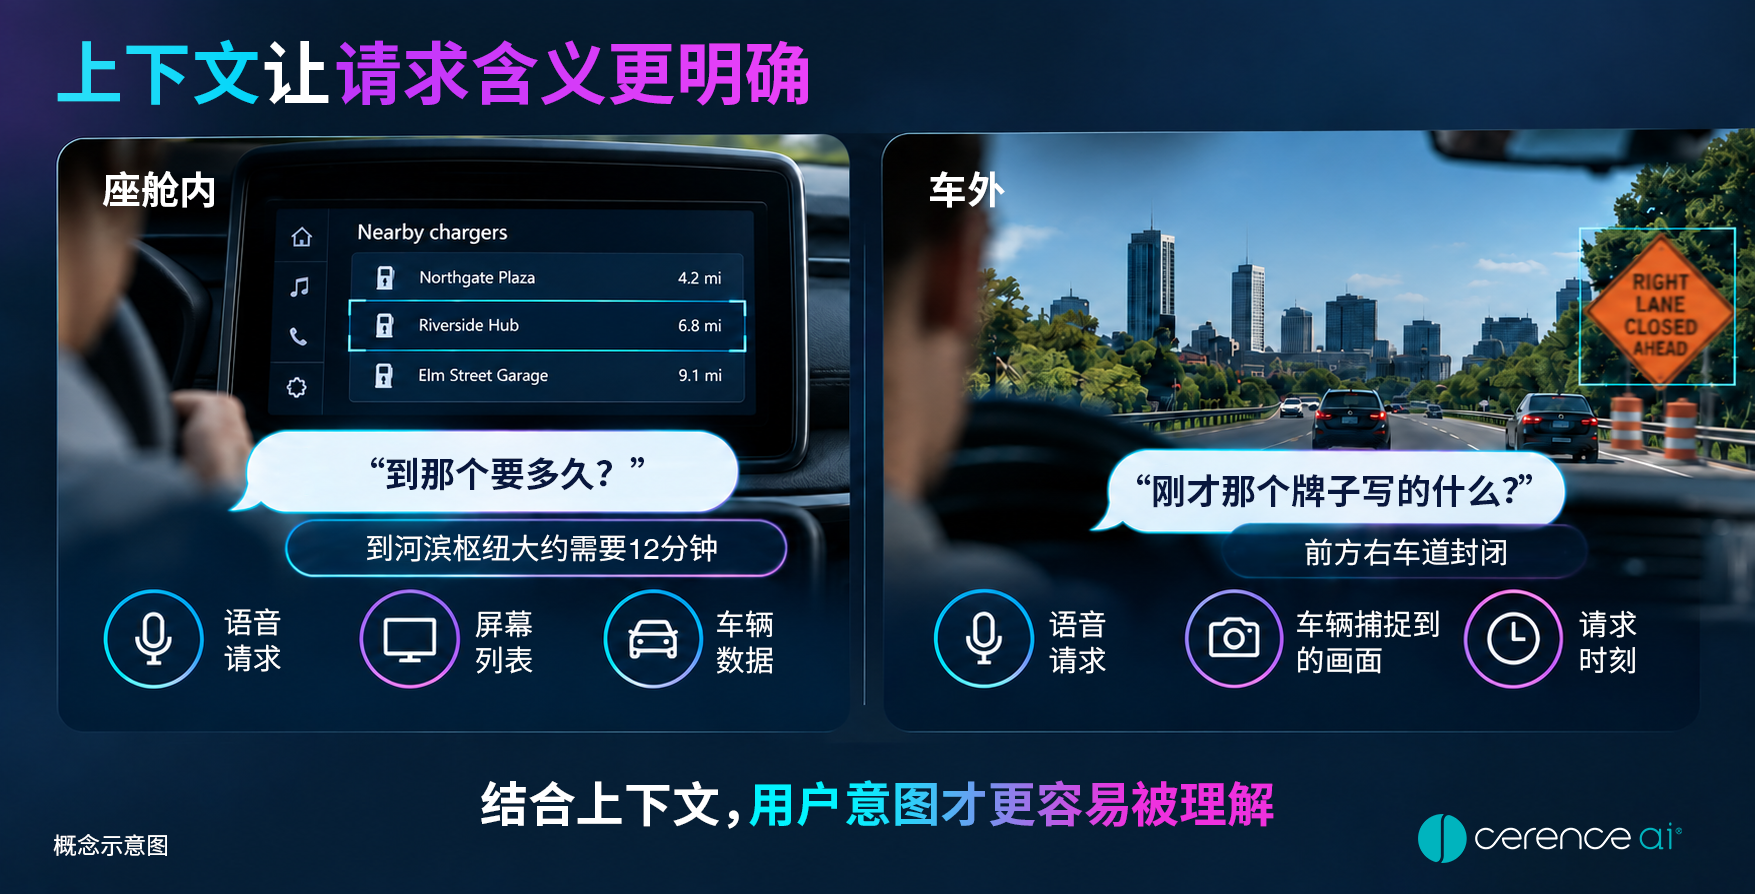
屏幕上显示着充电站列表,驾驶者问:“到那个要多久?”单靠这句话,无法判断他指的是哪座充电站;但屏幕上的内容可以。
xUI能够将屏幕显示状态、座舱信号、车辆数据与语音纳入同一推理流程,从而理解这类请求中驾驶者实际所指的充电站。否则,驾驶者就只能照着屏幕念出充电站名称,或把手从方向盘上移开,点击屏幕进行选择。
将上下文理解延伸至座舱之外
同样的推理能力,也可以延伸至挡风玻璃之外。
一块施工提示牌一闪而过,驾驶者还没来得及看清,便问:“刚才那个牌子写了什么?”助手回答:“14号出口后右侧车道封闭。”地图数据库中没有这条信息。这个标志可能今天早上才刚刚设置,下周就会拆除;唯一的记录,来自车辆刚刚捕捉到的画面。
这一架构将车外信号纳入同一推理流程,使助手能够根据车辆实际捕捉到的信息作答,而不是仅依赖数据库中关于这段道路的既有记录。
这将为OEM迎来哪些改变
对于正在评估车载语音方案的OEM而言,当多模态能力成为架构层面的设计,而不是后加的功能时,将带来三方面变化:
当驾驶者不必再把真实意图转换成机器听得懂的指令时,就能减少注意力从道路上转移。少一些与界面较劲的时间,就多一些手握方向盘、目视前方的时间。
能够基于完整音频信号进行推理的模型,相比依赖按语言分别构建固定流程的系统,更能自然地处理口音、方言以及多语言使用者的表达。过去需要单独流程支持的各个市场,开始可以作为同一类问题来处理,而不再是数十个彼此独立的难题。本地化、验证和针对特定市场的调优仍然不可或缺,但底层架构中可以共享的部分会更多。
个性化服务、主动式辅助和智能体,都依赖于系统对驾驶者正在做什么、看到了什么,以及提出了什么需求的理解。仍然只依靠转录文本工作的系统,无法让智能体基于座舱和道路的真实上下文进行理解和响应。
为何OEM当下的选择至关重要
一款车型今天选定的语音架构,将伴随驾驶者经历数代AI技术演进。在车辆生命周期的大部分时间里,它都可能面对由新能力持续塑造的市场环境,而这些能力在车辆上市时尚不存在。
OEM需要一套基础架构,能够随着音频、视觉、推理和智能体AI的进步持续演进。Cerence xUI正是为提供这一基础而设计,可在新模型和新能力逐步成熟、达到车规级部署要求后,将其纳入系统。
目标是让车载体验在车辆整个生命周期内持续提升,而不是停留在上市之初的能力水平。
贴合人类沟通方式的设计
从一开始,音频、视觉、座舱和道路就属于同一场对话。驾驶者不再需要把自己的意图转换成机器容易理解的指令;车辆也终于具备了以驾驶者熟悉的方式进行沟通所需的能力。
对于OEM而言,这不仅意味着当下更好的用户体验,也为下一代智能体奠定了所需的感知基础。
仅能处理文本的语音界面,正逐渐触及能力边界。xUI为下一阶段的车载交互而生,而这场对话今天就可以开始。


